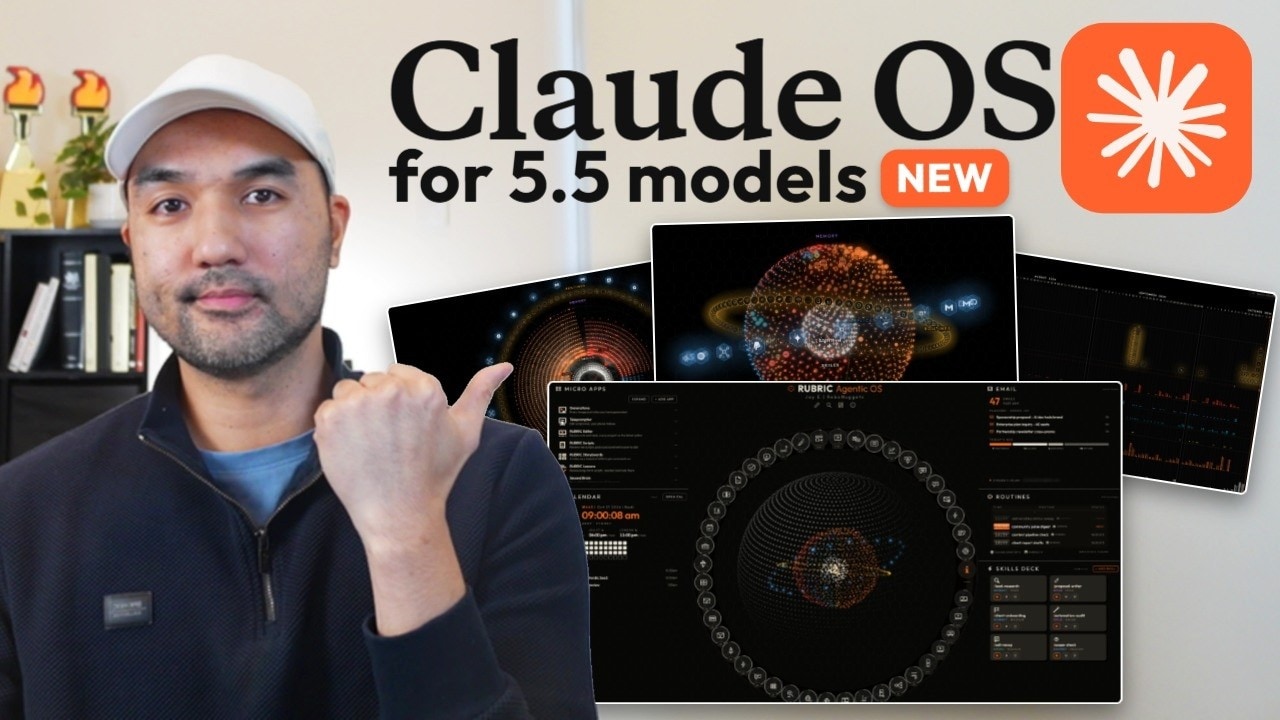
ลองนึกภาพว่าเปิดคอมขึ้นมาแล้วเจอหน้าจอเดียวที่รวมปฏิทิน อีเมลที่ควรตอบ งานที่ตั้งเวลาไว้ ไฟล์ทั้งหมด และแอปเล็ก ๆ ที่ AI สร้างไว้ให้ตรวจงานได้ทันที นี่คือระบบที่ Jay จากช่อง Jay E | RoboNuggets นำมาโชว์ในวิดีโอล่าสุด เขาเรียกมันว่า Agentic OS และใช้มันตัดต่อวิดีโอ ทำคอนเทนต์ และดูแลธุรกิจไปพร้อมกัน
จังหวะที่เรื่องนี้น่าสนใจคือเครื่องมือฝั่ง Claude เปลี่ยนเร็วมาก มีโมเดลตระกูล 5.5 ที่เก่งขึ้นชัดเจน มี Claude mods ที่ปรับพฤติกรรมของแอปได้ และมีโมเดลตัดสินใจชื่อ Jev ที่เร็วและถูกมาก หลายคนยังวางระบบ agent ตามคำแนะนำเมื่อไม่กี่เดือนก่อน ซึ่งเริ่มไม่เหมาะกับเครื่องมือชุดใหม่แล้ว บทความนี้จึงเรียบเรียงแนวคิดหลักให้เห็นว่าระบบแบบนี้ประกอบด้วยอะไรบ้าง และแต่ละส่วนช่วยให้ทำงานเร็วขึ้นและจ่ายน้อยลงได้อย่างไร
สรุปสั้น ๆ
- Agentic OS จัดระเบียบการทำงานของ agent ด้วยกรอบ ARMS คือ Apps, Routines, Memory และ Skills
- Skill แบ่งตามหน้าที่ได้เป็นคลังความรู้ งานสร้างชิ้นงาน และงานที่สั่งเองนอกแชท
- การส่งงานไปยังโมเดลที่เหมาะสมช่วยลดต้นทุนได้มาก โดยคุณภาพแทบไม่ตก
- Routine ที่เงียบและมีเพดานการใช้จ่าย ทำให้ตั้งงานอัตโนมัติได้มากโดยไม่ต้องไล่ตรวจทุกวัน
ARMS: ให้ agent มี "แขน" เอื้อมถึงพื้นที่ทำงาน
ระบบแบบนี้จะดีหรือไม่ขึ้นอยู่กับการจัดระเบียบบริบทและพื้นที่ทำงานมากกว่าตัวโมเดลเพียงอย่างเดียว กรอบที่จำง่ายคือ ARMS ซึ่งเปรียบเหมือนการให้ agent มีแขนไว้เอื้อมไปหยิบของ ได้แก่ Apps, Routines, Memory และ Skills ถ้าตั้งทั้งสี่ส่วนนี้ไว้ดี การใช้ agent ก็จะนำหน้าคนส่วนใหญ่ไปมาก
ส่วนที่เป็น Apps คือแอปเล็ก ๆ ที่สร้างขึ้นเองเพื่อช่วยทำงานร่วมกับ agent หน้าแรกของระบบตัวอย่างมีแอปสร้างและแสดงภาพหรือวิดีโอ แอปที่ใช้ตรวจแอนิเมชันแล้วคอมเมนต์กลับได้ง่าย แอปพักโพสต์ Instagram ให้กดอนุมัติ และแอปที่ agent เสนอการปรับปรุงระบบไว้ให้นำไปใช้ปลายสัปดาห์ แนวคิดสำคัญคือเมื่อ agent ผลิตชิ้นงานออกมา ควรมีที่พักที่เปิดดูและค้นหาได้เร็ว เพราะการสั่ง Claude ให้ไปควานหาไฟล์เก่าทุกครั้งกินโทเคนโดยใช่เหตุ ส่วนที่เหลืออีกสามตัวจะไล่ไปตามลำดับ
Skills: ไม่ใช่แค่ขั้นตอน แต่เป็นคลังความรู้ด้วย
คนส่วนใหญ่มอง skill เป็น SOP ที่มีขั้นตอนชัดเจน แต่ skill ยังทำหน้าที่เป็นที่เก็บความรู้ได้ด้วย ประเภทแรกคือ database skill เช่น skill ที่เก็บหลักการและตัวอย่างน้ำเสียงการเขียนของเจ้าของระบบ เพื่อให้ agent ร่างอีเมลหรือโพสต์ได้ตรงโทนตั้งแต่ร่างแรก หรือ skill ที่เก็บคลังภาพปกวิดีโอพร้อมพาธไฟล์ ข้อควรระวังคือ over-fitting เพราะถ้าให้ตัวอย่างอ้างอิงมากเกินไป agent จะยึดตามตัวอย่างจนไม่มีไอเดียใหม่ วิธีแก้คือกำหนดให้ skill แทรก wild card เป็นค่าเริ่มต้น เช่น เสนอ 10 ชื่อบทความ โดย 8 อันอิงคลังตัวอย่าง และอีก 2 อันไม่อิงเลย อันไหนดีค่อยเก็บเข้าคลังเป็นแนวใหม่
ประเภทที่สองคือ artifact skill ชิ้นงานอย่างอินโฟกราฟิก สไลด์ หรือ PDF ไม่เหมาะกับหน้าต่างแชท รูปแบบที่ agent ทำได้ดีมากคือ HTML แล้วค่อยส่งออกเป็น PDF อีกที ถ้าผูก skill เข้ากับคู่มือแบรนด์ที่ระบุสี ฟอนต์ และสไตล์ ชิ้นงานทุกชิ้นจะหน้าตาสม่ำเสมอและไม่ออกมาเป็นงาน vibe-code ทั่วไป นอกจากนี้ควรมีกล่องรวมชิ้นงานให้ค้นหาเองได้ แทนการสั่งให้ Claude ไปหา
ประเภทที่สามคือ self-triggered skill ซึ่งเหมาะกับงานที่สะดวกกว่าถ้ากดสั่งเองนอกแชท เช่น skill ล้างไฟล์ชั่วคราวเมื่อเครื่องเริ่มช้า ระบบเลือกโมเดลและระดับความพยายามได้ตั้งแต่หน้าสั่งงาน โดยพึ่งโหมด claude -p ซึ่งปลุก Claude ในพื้นหลังด้วยพรอมต์เดียวโดยไม่ต้องเปิดแชท
ประหยัดโควตาด้วยการเลือกโมเดลให้ถูกงาน
ข้อผิดพลาดที่พบบ่อยคือสร้าง skill ไว้แล้วลืม จึงปล่อยให้ทุกอันรันบนโมเดลใหญ่ราคาแพง ทั้งที่งานจำนวนมาก โดยเฉพาะที่มีขั้นตอนตายตัว รันบน Sonnet หรือ Haiku ได้สบาย เช่น skill ตรวจตัวสะกดที่รันบน Haiku เร็วกว่าและถูกกว่ามาก
ขั้นถัดไปคือใช้ Jev ซึ่งเป็นโมเดลจำแนกประเภทที่เร็วกว่าโมเดลระดับแนวหน้าราว 200 เท่าและถูกกว่าราว 400 เท่า ให้ตัดสินใจว่าพรอมต์แต่ละอันควรไปโมเดลไหน ตัวเลขจากระบบตัวอย่างคือราว 4,451 ครั้งในไม่กี่สัปดาห์ ครั้งละประมาณ 0.6 วินาที รวมแล้วเสียเงินราว 18 เซนต์ และประมาณ 4 ใน 10 ถูกส่งไป Haiku โดยไม่รู้สึกว่าคุณภาพตก วิธีทดสอบว่าเหมาะกับเราไหมก็คือดูว่าการถูกส่งไปโมเดลเล็กทำให้เราหงุดหงิดหรือเปล่า ควรมีแดชบอร์ดดู skill ที่ใช้โควตามากที่สุดด้วย เพราะ skill ที่ใช้บ่อยและกินโทเคนหนักจะได้รับการปรับให้เบาก่อน
ระดับสูงสุดคือทำให้ skill พัฒนาตัวเองจากฟีดแบ็ก ตัวอย่างคือแอปที่ใช้คอมเมนต์ลงบนวิดีโอพร้อมไทม์สแตมป์และตำแหน่งที่ปักหมุด เมื่อรวมคอมเมนต์ทั้งหมดส่งให้ Claude จะมีสวิตช์แนบคำสั่งให้ปรับปรุง skill ตัดต่อและ skill แอนิเมชันไปในตัว ยิ่งใช้และยิ่งให้ฟีดแบ็ก skill ก็ยิ่งแม่นขึ้น ซึ่งเป็นรูปแบบง่าย ๆ ของ reinforcement learning ที่ห้องแล็บ AI ใช้พัฒนาโมเดลอยู่แล้ว
Routines: ให้ agent ทำงานตามเวลาโดยไม่รกหน้าจอ
Routine คืองานที่ Claude รันตามตารางเวลา และแบ่งได้เป็นสองแบบ แบบ active ทำงานแล้วส่งผลให้ตรวจ เช่น สรุปอีเมลประจำวันส่งเข้า Telegram ส่วนแบบ passive รันเงียบ ๆ และเตือนเฉพาะเมื่อเจอสิ่งที่ควรรู้ เช่น งานตรวจรายสัปดาห์ว่ามีเว็บไซต์ใดแอบใช้แบรนด์โดยไม่ได้รับอนุญาตหรือไม่ ถ้าไม่เจอก็ไม่ส่งอะไรมารบกวน
ถ้า routine ทุกตัวต้องรีวิวผลทุกครั้ง พอมี 50 ตัวก็จะมี 50 เรื่องให้ตรวจทุกสัปดาห์ ซึ่งเกินกว่าที่ใครจะรับไหว
แนวทางจึงคือใช้ passive routine ให้มากที่สุด เช่น เฝ้าดูโดเมนที่น่าสนใจว่าว่างหรือยัง หรือคอยดูแลเครื่องว่ามีแอปใดทำให้ช้า
เรื่องต้นทุนก็สำคัญไม่แพ้กัน ทุกงานที่ตั้งเวลาไว้กินโควตาหรือเครดิต API ถ้ามีมากก็ลืมได้ง่ายว่าตัวไหนแพง การมีหน้ารวม routine ที่เรียงตามโทเคนที่ใช้ต่อสัปดาห์ช่วยให้เห็นตัวที่ควรปรับ แล้วสั่งให้ Claude ลดการใช้โดยกำหนดเพดาน เช่น จากราว 10 ดอลลาร์ต่อสัปดาห์เหลือ 4 ดอลลาร์ ซึ่งมักตัดส่วนที่ฟุ่มเฟือยออกได้ ขั้นสุดท้ายคือมี routine ที่แนะนำ routine ใหม่ โดยทุกวันศุกร์จะย้อนดูแชทที่ผ่านมา หางานที่เรายังทำซ้ำด้วยมืออยู่ แล้วเสนอเป็นรายการให้เลือกนำไปใช้ก่อนโควตารีเซ็ต ระบบจึงดีขึ้นเองทุกสัปดาห์
Memory: ความรู้ที่เรียกใช้ได้เร็วและถูก
Memory คือทุกสิ่งที่ Claude รู้เกี่ยวกับเราและงานของเรา และสำคัญไม่แพ้กันคือเรียกกลับมาได้เร็วและถูกแค่ไหน เมื่อใช้ agent นานขึ้นไฟล์ก็สะสมมาก การค้นทั้งหมดทุกครั้งทั้งช้าและเปลืองโควตา ระดับแรกคือ long-term memory หรือที่คนเรียก second brain ซึ่งแท้จริงแล้วก็คือไฟล์ในโฟลเดอร์ทำงาน ตัวอย่างในวิดีโอมีราว 400,000 ไฟล์ แสดงเป็นกราฟสามมิติที่แต่ละจุดคือไฟล์และเส้นเชื่อมแสดงความสัมพันธ์ ซึ่งช่วยให้ agent หาของที่ต้องการได้เร็วขึ้น และยังมีช่องค้นหาที่สะดวกกว่าตัวสำรวจไฟล์ปกติ รวมถึงไทม์ไลน์ว่าไฟล์ skill และ routine ไหนถูกแก้ล่าสุด
บทสรุป
ถ้าดูภาพรวม ระบบทั้งหมดไม่ได้อาศัยความซับซ้อนทางเทคนิคเป็นหลัก แต่เป็นการจัดระเบียบสี่ส่วนให้ agent เอื้อมถึงได้ง่าย แยก skill ตามหน้าที่ ส่งงานไปโมเดลที่เหมาะ ตั้ง routine แบบเงียบและมีเพดาน และเก็บความรู้ให้ค้นได้เร็ว ไม่จำเป็นต้องทำครบทุกอย่างในวันเดียว
จุดเริ่มต้นที่เป็นรูปธรรมคือไล่ดูว่า skill ไหนใช้บ่อยที่สุด แล้วลองย้ายตัวที่ขั้นตอนตายตัวไปรันบนโมเดลเล็ก จากนั้นเปลี่ยน routine สักหนึ่งตัวให้เป็นแบบเงียบ แล้วดูว่าโควตาที่ประหยัดได้เป็นอย่างไร